IA generativa e lead locali: come collegare le citazioni IA a lead reali
Una chiamata persa alle 22, una ricerca del brand su Google, un modulo compilato il giorno dopo: l’IA potrebbe aver aiutato nella decisione, senza comparire chiaramente nei vostri report. L’argomento merita più di un riflesso, richiede una diagnosi.

Lila HNAT BENGUEDACH
Pubblicato il 11 min di lettura
Aprite i vostri strumenti di analytics, filtrate i referral provenienti da strumenti come ChatGPT, Gemini o Perplexity, e il verdetto sembra rapido: quasi nulla. Il problema è che questa lettura può essere troppo sbrigativa.
I pareri convergono su un punto: nel locale, gli assistenti IA possono influenzare la scoperta di un’azienda senza generare immediatamente un clic misurabile. Al contrario, divergono sulla solidità dei numeri, sulla portata reale dei segnali e sulle raccomandazioni da generalizzare.
Da BL Digital, la nostra posizione è semplice: il riflesso non è una strategia, si fa una diagnosi prima di agire. Ecco quindi ciò che sappiamo, ciò che possiamo ragionevolmente dedurre e ciò che bisogna ancora verificare prima di trasformare una tendenza in un piano d’azione. 💡
Perché i lead provenienti dall’IA restano difficili da attribuire
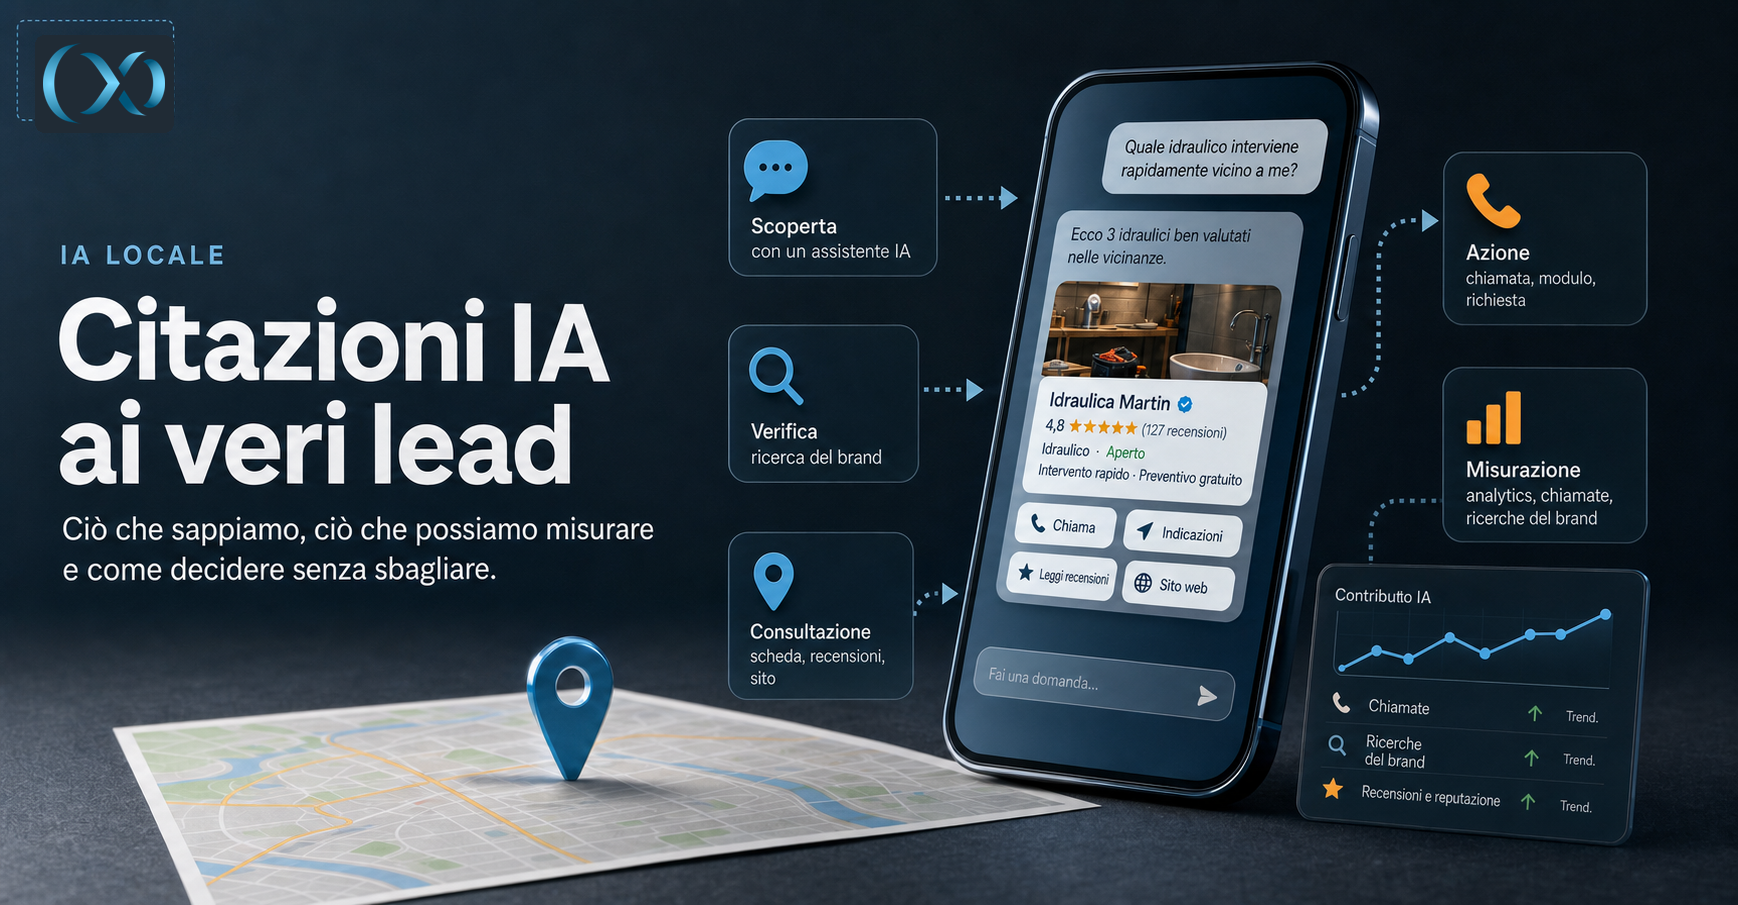
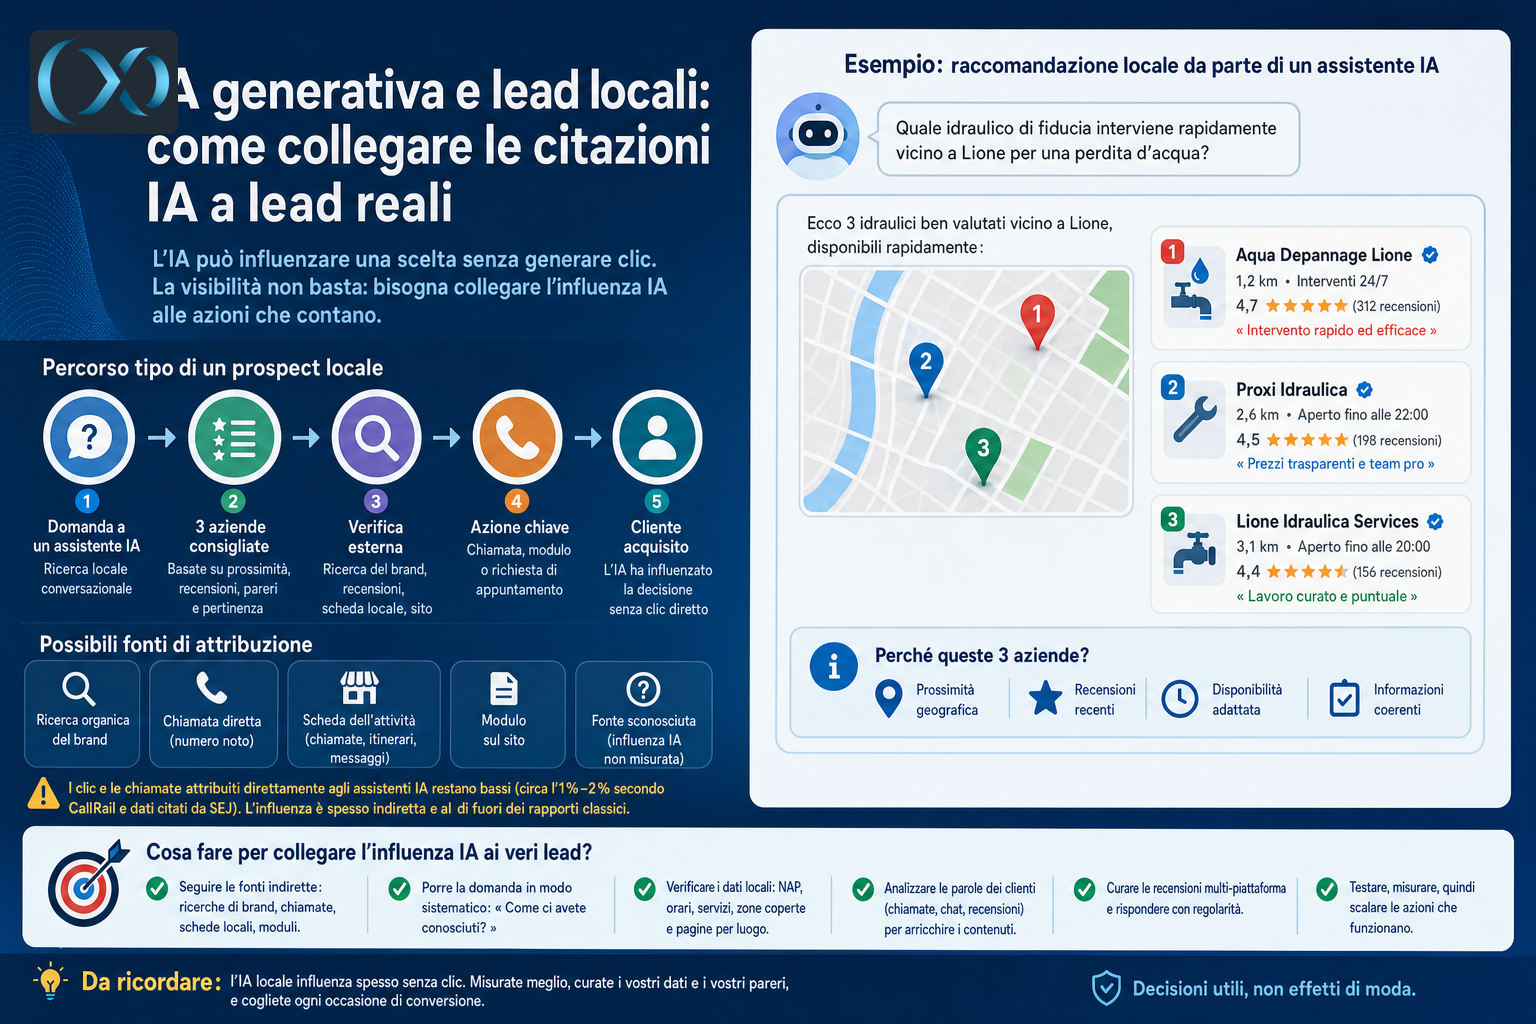
Il percorso descritto dalle fonti è coerente: un utente pone una domanda locale a un assistente, vede alcune aziende consigliate, poi passa da un’altra porta d’ingresso per agire.
Concretamente, può assomigliare a questo:
- scoperta iniziale in un assistente IA;
- verifica tramite una ricerca del brand;
- consultazione della scheda dell’attività, delle recensioni o del sito;
- chiamata, modulo, prenotazione di un appuntamento.
In questo scenario, l’assistente ha contribuito alla decisione, ma il lead sarà spesso registrato altrove: traffico organico di brand, chiamata diretta, interazione con la scheda locale, o fonte sconosciuta se nessuno pone la domanda al cliente.
È precisamente l’angolo sviluppato dall’articolo di Search Engine Journal sul legame tra visibilità IA e lead locali, a partire da uno scambio tra Sean McCrohan di CallRail e Steve Wiideman. La difficoltà non è quindi solo “portare traffico IA”, ma ricostruire un contributo parziale in un percorso in più fasi.
Ciò che i numeri permettono di affermare, senza sovrainterpretarli
Emergono diversi numeri, ma non si equivalgono tutti. Bisogna leggerli con prudenza, perché provengono da interlocutori, fornitori o articoli secondari.
I clic o le chiamate attribuiti all’IA restano bassi, ma in aumento secondo gli interlocutori citati
Search Engine Journal riporta che, secondo Sean McCrohan, i clic o le chiamate legati alle citazioni IA rappresenterebbero circa l’1% al 2% delle chiamate presso i clienti di CallRail, con un aumento approssimativamente raddoppiato da gennaio. Lo stesso articolo indica che Steve Wiideman osserva un ordine di grandezza vicino all’1% in GA4 per i brand multi-sito e i franchising che segue.
Il punto importante non è trattenere una percentuale universale. Il punto importante è questo: i segnali misurabili esistono, ma restano modesti negli ambienti citati.
In altre parole, se cercate già un’esplosione di traffico direttamente attribuibile agli assistenti, rischiate di restare delusi. Se invece cercate un segnale emergente di scoperta, questi dati suggeriscono che merita di essere monitorato.
Le ricerche assistite dall’IA sembrano estendersi maggiormente fuori dagli orari di apertura
Sempre secondo gli interlocutori citati da Search Engine Journal, il traffico web “ordinario” osservato da CallRail si distribuirebbe storicamente attorno alla metà fuori dagli orari classici, mentre la quota legata all’IA salirebbe a quasi due terzi.
È un punto operativo interessante, soprattutto per le attività locali ad alta intenzione, come i servizi urgenti. Se un assistente mette in evidenza tre fornitori, una chiamata persa può spostarsi sul successivo.
Anche qui, prudenza: non è una legge generale del web locale. È un feedback di esperienza di un fornitore riportato da un media. Ma per un lettore che gestisce un centralino, prenotazioni o supporto fuori orario, è un segnale molto concreto da sorvegliare. 🔎
Dove il call tracking si complica davvero
Una delle parti più utili del corpus riguarda il telefono. Molte aziende locali vivono di chiamate, non solo di moduli. Ed è proprio qui che l’attribuzione diventa fragile.
Il problema degli script lato browser
Search Engine Journal riporta un punto tecnico avanzato da Sean McCrohan: i crawler utilizzati dagli agenti IA non eseguirebbero gli script della pagina come un browser classico. Se il vostro sistema di tracciamento si basa su una sostituzione del numero in JavaScript lato client, l’agente potrebbe non vedere mai quel numero dinamico.
In parole semplici, l’assistente può leggere il numero predefinito nell’HTML statico, non quello iniettato più tardi nella pagina.
È una sfumatura importante perché evita una scorciatoia falsa e frequente: “il mio tracking è attivo, quindi anche la mia attribuzione IA lo è”. Non necessariamente.
Il ricorso al server-side non vale come via libera senza test
Lo stesso articolo riporta che delle sostituzioni lato server possono funzionare, pur menzionando un avvertimento sui rischi legati al cloaking e alla coerenza dei dati locali.
È un buon esempio di contraddizione utile da conservare tale e quale:
- da un lato, un trattamento lato server può esporre meglio alcune informazioni ai crawler;
- dall’altro, qualsiasi variazione in base allo user-agent richiede estrema prudenza.
La documentazione ufficiale di Google sulle norme anti-spam e in particolare sul cloaking ricorda perché questo tema non deve essere improvvisato con leggerezza.
La lettura corretta non è quindi “bisogna fare server-side”. La lettura corretta è: se la vostra attribuzione telefonica dipende dal browser, verificate prima che cosa vede realmente il bot e che cosa vede l’utente.
La coerenza dei dati locali resta una base più credibile di un trucco
Su questo terreno, la maggior parte dei feedback è abbastanza coerente nonostante le differenze di qualità. Gli articoli di Search Engine Journal e di Digital360 insistono sulla necessità di mantenere informazioni locali stabili e concordanti:
- nome dell’azienda;
- indirizzo;
- telefono;
- orari;
- zone servite;
- pagine locali utili per ogni sede.
Non è una novità, ed è proprio questo che rende il segnale interessante: l’IA non sostituisce bruscamente il SEO locale, ne riutilizza una parte delle fondamenta.
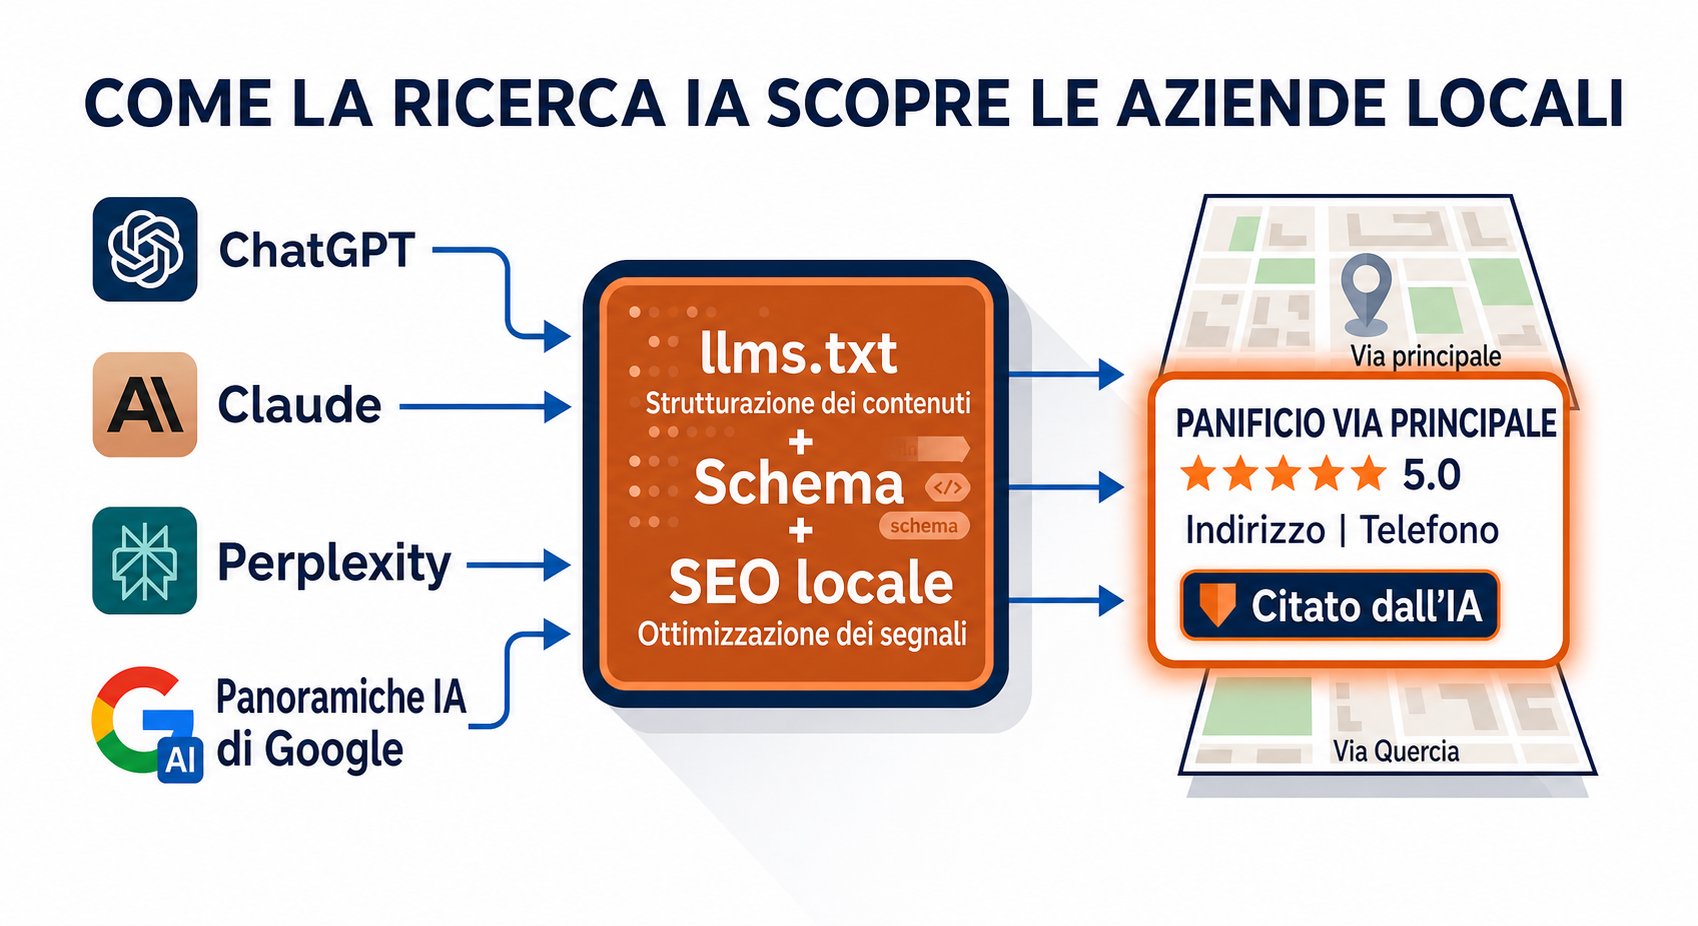
Il testo promozionale di Chaz Edward aggiunge livelli come llms.txt, schema e “AI readiness”, ma ciò non fornisce una prova solida che questi elementi sarebbero, da soli, determinanti per la raccomandazione locale da parte degli assistenti. Si impone quindi prudenza.
Al contrario, su un punto più classico, la documentazione Google sulle buone pratiche di contenuto per le funzionalità IA della ricerca e sulle funzionalità IA nella ricerca Google va nella direzione di un lavoro di fondo: contenuto utile, informazioni comprensibili, struttura sfruttabile, segnali coerenti.
Perché la “posizione” in un assistente non è una metrica stabile
L’altra idea forte riguarda ciò che Steve Wiideman chiama prompt drift. Search Engine Journal cita un’analisi di Steady Demand secondo cui, per ricerche locali ripetute in Gemini, le fonti citate si sovrapporrebbero circa il 40% delle volte, e il brand raccomandato in testa tornerebbe solo circa il 7% delle volte, contro una stabilità di circa 90% per il local pack di Google.
Questi numeri sono interessanti, ma si basano su una fonte secondaria rilanciata da un media, non su uno studio metodologico dettagliato. Bisogna quindi trattenere soprattutto l’idea generale: le risposte degli assistenti possono variare fortemente in base alla formulazione, al contesto o alla sessione.
Conseguenza pratica: seguire “la posizione #1 in ChatGPT” come si seguiva un ranking classico ha poco senso. Meglio osservare delle tendenze:
- il vostro brand è citato più spesso?
- le informazioni sono esatte?
- quali pagine o quali fonti supportano queste risposte?
- gli stessi fatti riappaiono nel tempo?
È per questo motivo che diverse fonti evocano delle librerie di prompt o di formulazioni da controllare, piuttosto che un ranking unico.
Le parole dei vostri clienti valgono spesso più di un brainstorming SEO
Su questo punto, il corpus è particolarmente utile perché si ricollega a una pratica semplice. Search Engine Journal insiste sul valore delle trascrizioni delle chiamate e dei log di chat per capire come i clienti formulano realmente i loro bisogni.
L’idea non ha nulla di spettacolare, ma è solida: gli assistenti rispondono a formulazioni conversazionali, non solo a parole chiave brevi e rigide. Se il vostro sito parla un linguaggio marketing molto pulito, ma lontano dalle domande che i vostri prospect pongono al telefono, può esserci uno scarto.
Potete quindi fare un audit di:
1. le parole usate per descrivere un problema;
2. le domande poste prima dell’acquisto;
3. le preoccupazioni ricorrenti su prezzo, tempi, area coperta;
4. le espressioni usate dai vostri clienti che il vostro sito non usa mai.
È una pista utile, a condizione di rispettare la riservatezza, l’accesso ai dati e le regole applicabili alla registrazione o all’analisi delle conversazioni.
Le recensioni non scompaiono dal panorama, cambiano di portata
Tutti concordano sull’importanza delle recensioni multi-piattaforma, non solo quelle di Google Business Profile. Search Engine Journal riporta che Steve Wiideman cita in particolare Yelp, ricordando i suoi collegamenti con Bing, Apple Maps e la sua partnership con ChatGPT.
Evoca anche una zona obiettivo di circa 4,5 a 4,7 di valutazione media. Anche qui, bisogna evitare la trappola del numero magico. Non è una soglia ufficiale universale, è un riferimento citato in uno scambio professionale.
Ciò che si può trattenere con maggiore sicurezza:
- recensioni recenti e credibili restano segnali di rassicurazione;
- la presenza su più piattaforme può contare se gli assistenti aggregano fonti diverse;
- una reputazione locale assente o incoerente può indebolire la fiducia.
In altre parole, se la vostra strategia di recensioni si limita a una sola piattaforma, non è necessariamente sbagliata, ma è forse troppo limitata per un ambiente in cui si incrociano più insiemi di dati.
Un metodo ragionevole per iniziare, senza trasformare un segnale debole in certezza
Se gestite un’azienda locale o una rete di sedi, ecco un metodo più prudente della caccia all’“hack IA”:
1. Identificate il livello esatto del sintomo
Chiedetevi prima di tutto:
- mancano citazioni visibili negli assistenti?
- si ricevono ricerche del brand senza comprenderne l’origine?
- si osservano chiamate perse fuori orario?
- il problema riguarda dati locali incoerenti?
- o la conversione dopo la visita?
Senza questa selezione, rischiate di applicare una risposta tecnica a un problema commerciale, o il contrario.
2. Create un monitoraggio minimo, ma pulito
Cominciate con:
- un segmento analytics per i referral IA identificabili;
- una domanda “Come ci avete conosciuti?” nei moduli o negli script di chiamata;
- una qualificazione semplice delle chiamate: nuovo lead, cliente esistente, fuori target, chiamata persa;
- una rilevazione delle ricerche di brand e delle azioni sulle schede locali.
Non è perfetto, ma è già più utile di un verdetto binario del tipo “l’IA non serve a nulla” o “tutto viene dall’IA”.
3. Verificate che cosa dicono davvero le vostre pagine a una macchina
Controllate almeno:
- il numero principale visualizzato nell’HTML;
- la coerenza NAP tra sito, profili e directory;
- gli orari, le zone servite e i servizi per luogo;
- l’esistenza di pagine locali davvero utili, non duplicati sottili;
- la presenza di risposte chiare a vere domande dei clienti.
4. Testate prima azioni reversibili
Alcuni esempi di azioni reversibili:
- migliorare una pagina locale prioritaria;
- chiarire un numero di chiamata e gli orari;
- captare meglio le richieste fuori orario;
- arricchire le risposte a domande ricorrenti;
- avviare un audit delle recensioni su più piattaforme.
Al contrario, tutto ciò che riguarda variazioni di contenuto in base all’agente, attribuzione telefonica complessa o file e segnali presentati come miracolosi merita un test limitato, documentato e rivisto.
Ciò che le reti multi-sito devono monitorare ancora più attentamente
Il corpus insiste giustamente sulla governance per i brand multi-sito. Più luoghi avete, più esponete:
- numeri non autorizzati;
- orari divergenti;
- descrizioni locali contraddittorie;
- schede duplicate;
- risposte alle recensioni molto disomogenee.
Search Engine Journal riporta che Steve Wiideman colloca addirittura questa governance al di sopra di alcuni segnali di ranking classici su larga scala. La formula è forte, ma l’idea è credibile: quando gli assistenti aggregano fonti multiple, il disordine locale diventa più costoso.
Per una rete, la priorità non è quindi solo “apparire nell’IA”. È evitare che l’IA ricomponga un’immagine incoerente del brand a partire da dati sparsi.
La giusta decisione iniziale dipende dal vero sintomo, non dalla parola di moda
Se doveste trattenere una sola cosa, è questa: la visibilità negli assistenti IA può già contribuire a lead locali, ma le prove dirette restano parziali, deboli in volume e molto dipendenti dal contesto.
La domanda giusta non è “come ottimizzare per l’IA?”. La domanda giusta è piuttosto:
- quale livello di cache è coinvolto? Qui, per analogia operativa, quale livello del percorso conserva la traccia: referral visibile, ricerca del brand, chiamata, scheda locale, o nulla del tutto?
- quale sintomo si osserva? Traffico referral debole, chiamate fuori orario, incoerenze nei dati, mancanza di citazioni, scarsa conversione?
- quali fatti sono verificati? Numeri interni, log, chiamate qualificate, fonti citate, test tecnici?
- quale azione è reversibile? Modificare una pagina, migliorare la raccolta dell’attribuzione, correggere i dati locali, testare un dispositivo fuori orario.
È meno spettacolare di una promessa di “AI visibility”. Ma è molto più solido per prendere una decisione utile.
Per alcune aziende, forse è già una partita persa in partenza se lasciano che l’IA influenzi la decisione senza nemmeno misurarne il impatto reale nel tempo. E siccome tutto va molto veloce, la cosa più redditizia resta spesso limitare le occasioni mancate : dati locali incoerenti, chiamate perse, pagine locali deboli e assenza di una domanda di attribuzione lato team.
Nella stessa rubrica
- ChatGPT Video: Come Attivare Questa Funzionalità?
Argomenti in comune : Digitale · ChatGPT · IA
- JetGEO, la novità di Crocoblock per WordPress: controllo dei crawler IA o semplice strato marketing?
Argomenti in comune : Digitale · SEO · IA
- November 2021 Spam Update: Google Sta Implementando un Nuovo Aggiornamento ai suoi Algoritmi
Argomenti in comune : Analytics · Digitale · SEO
- Search Profiles Google: cosa cambia per i media e i creator americani a settembre 2026
Argomenti in comune : Digitale · SEO
Caso Revolut: come una PEC ha potuto servire a una Fuga di dati
Una PEC italiana sarebbe stata usata per ottenere i dati di centinaia di clienti Revolut. I fatti noti, la posta in gioco del KYC…
Leggi l’articolo
TikTok Smaschera il Lusso: le Fabbriche Cinesi Rivelano Tutto
📢 “Chinese manufacturers” — La guerra commerciale tra Cina e Stati Uniti svela i retroscena del lusso: i produttori cinesi passano all’attacco.
Leggi l’articolo
Code my Crown di DOVE: Pioniere della Diversità dei Tagli Afro nel Mondo dei Videogiochi
Dove rivoluziona la rappresentazione dei tagli afro nei videogiochi e oltre, aprendo la strada a una maggiore diversità nel mondo digitale. 👑💇🏾♀️🎮
Leggi l’articolo