IA générative et leads locaux : comment relier des citations IA à de vrais leads
Un appel manqué à 22 h, une recherche de marque dans Google, un formulaire rempli le lendemain : l’IA a peut-être aidé à la décision, sans apparaître nettement dans vos rapports. Le sujet mérite mieux qu’un réflexe, il demande un diagnostic.

Lila HNAT BENGUEDACH
Publié le 11 min de lecture
Vous ouvrez vos outils analytics, vous filtrez les referrals en provenance d’outils comme ChatGPT, Gemini ou Perplexity, et le verdict semble rapide : presque rien. Le problème, c’est que cette lecture peut être trop courte.
Les avis convergent sur un point : dans le traffic local, les assistants IA peuvent influencer la découverte d’une entreprise sans générer immédiatement un clic mesurable. En revanche, elles divergent sur la robustesse des chiffres, la portée réelle des signaux et les recommandations à généraliser.
Chez BL Digital, notre position est simple : le réflexe n’est pas une stratégie, on diagnostique avant d’agir. Voici donc ce que l’on sait, ce que l’on peut raisonnablement en déduire, et ce qu’il faut encore vérifier avant de transformer une tendance en plan d’action. 💡
Pourquoi les leads issus de l’IA restent difficiles à attribuer
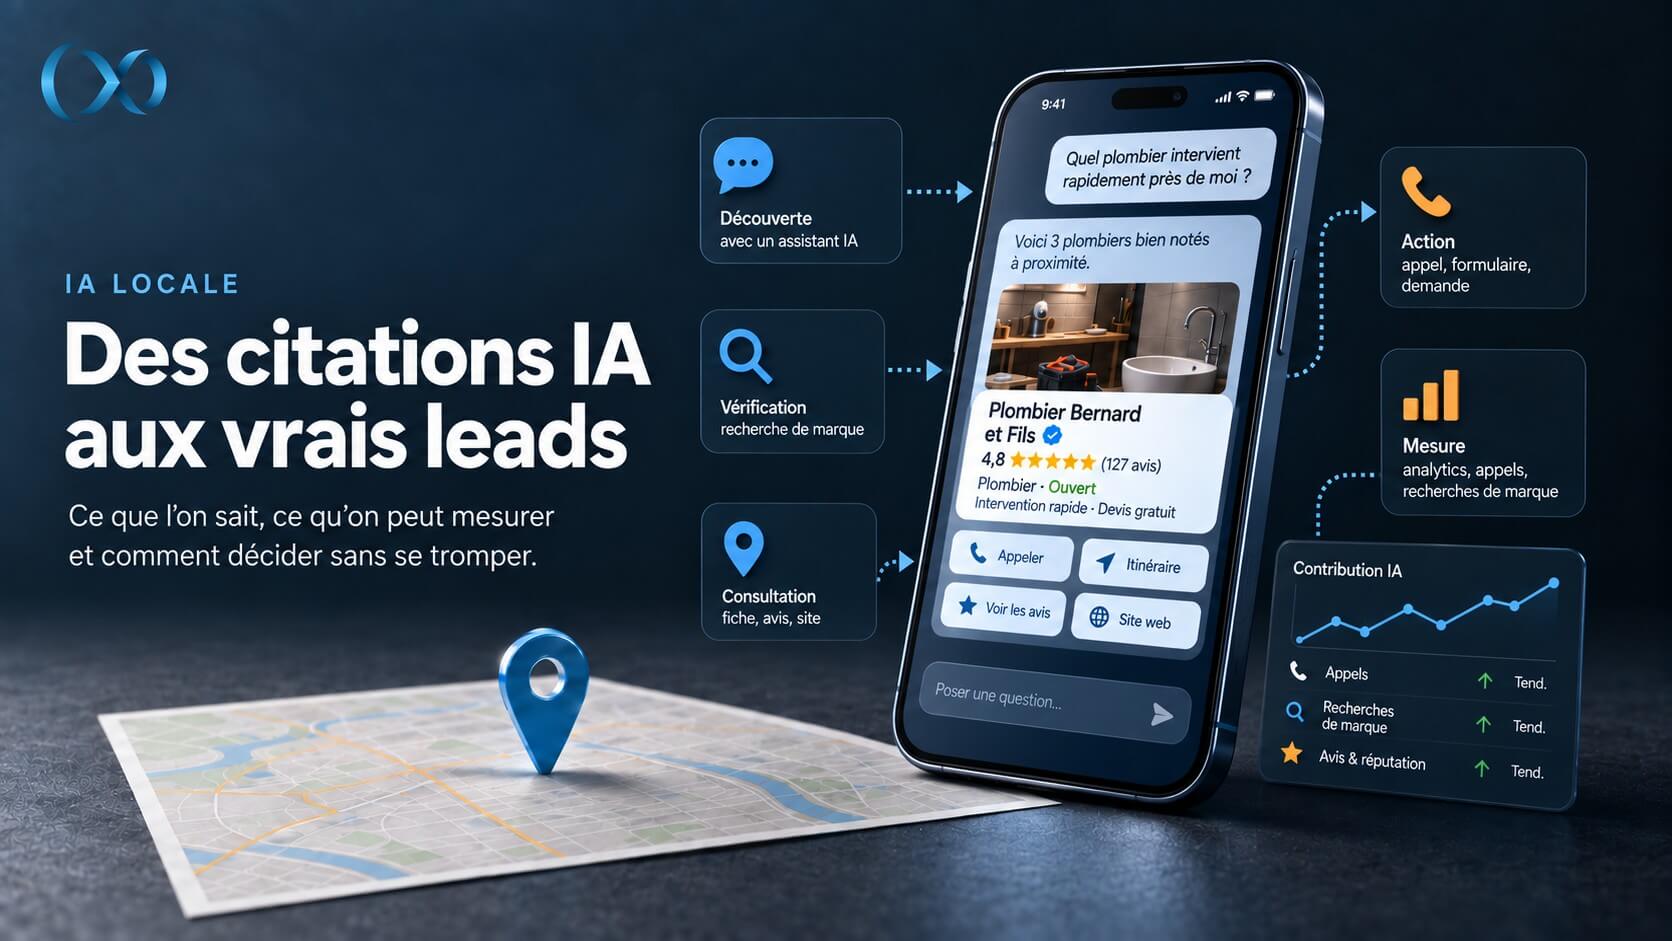
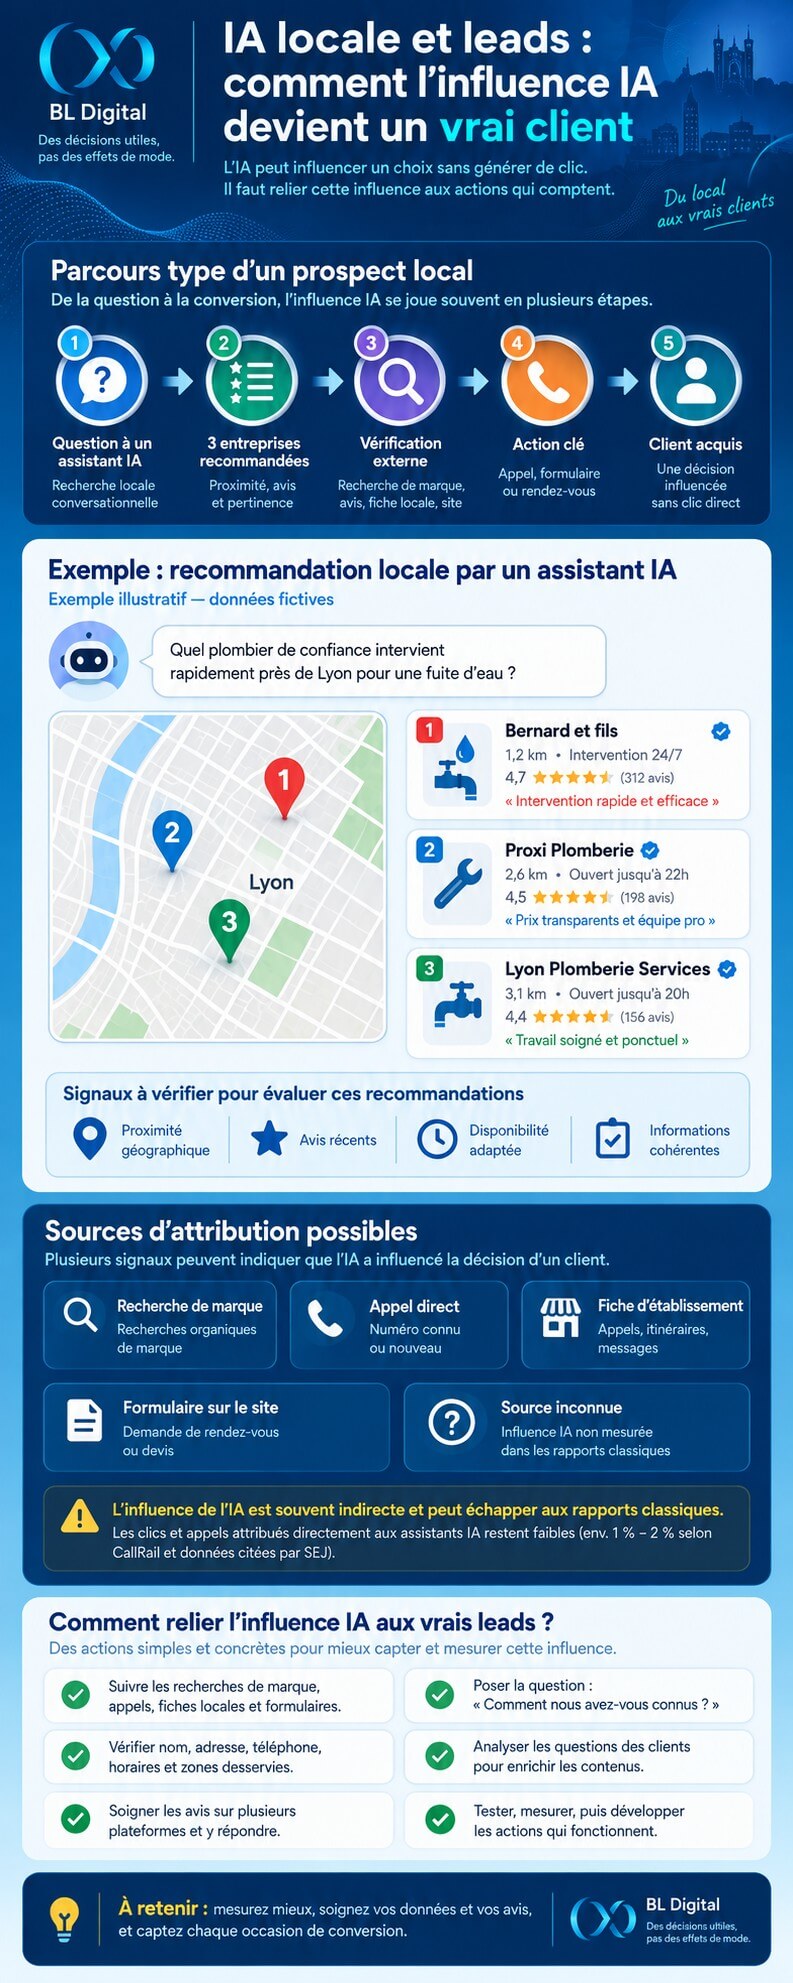
Le parcours décrit par les sources est cohérent : un utilisateur pose une question locale à un assistant, voit quelques entreprises recommandées, puis passe par une autre porte d’entrée pour agir.
Concrètement, cela peut ressembler à ceci :
- découverte initiale dans un assistant IA ;
- vérification par une recherche de marque ;
- consultation de la fiche d’établissement, des avis ou du site ;
- appel, formulaire, prise de rendez-vous.
Dans ce scénario, l’assistant a contribué à la décision, mais le lead sera souvent enregistré ailleurs : trafic organique de marque, appel direct, interaction avec la fiche locale, ou source inconnue si personne ne pose la question au client.
C’est précisément l’angle développé par l’article de Search Engine Journal sur le lien entre visibilité IA et leads locaux, à partir d’un échange entre Sean McCrohan de CallRail et Steve Wiideman. La difficulté n’est donc pas seulement de “faire venir du trafic IA”, mais de reconstruire une contribution partielle dans un parcours multi-étapes.
Ce que les chiffres permettent d’affirmer, sans les surinterpréter
Plusieurs chiffres ressortent, mais ils ne se valent pas tous. Il faut les lire avec prudence, car ils proviennent d’intervenants, de fournisseurs ou d’articles secondaires.
Les clics ou appels attribués à l’IA restent faibles, mais en hausse selon les intervenants cités
Search Engine Journal rapporte que, selon Sean McCrohan, les clics ou appels liés aux citations IA représenteraient environ 1 % à 2 % des appels chez les clients de CallRail, avec une hausse approximativement doublée depuis janvier. Le même article indique que Steve Wiideman observe un ordre de grandeur proche de 1 % dans GA4 pour les marques multi-sites et franchises qu’il accompagne.
Le point important n’est pas de retenir un pourcentage universel. Le point important est celui-ci : les signaux mesurables existent, mais restent modestes dans les environnements cités.
Autrement dit, si vous cherchez déjà une explosion de trafic directement attribuable aux assistants, vous risquez d’être déçu. Si, en revanche, vous cherchez un signal émergent de découverte, ces données suggèrent qu’il mérite d’être suivi.
Les recherches assistées par l’IA semblent déborder davantage hors horaires ouvrés
Toujours selon les intervenants cités par Search Engine Journal, le trafic web “ordinaire” observé par CallRail se répartirait historiquement autour de la moitié hors horaires classiques, tandis que la part liée à l’IA monterait près des deux tiers.
C’est un point opérationnel intéressant, surtout pour les activités locales à forte intention, comme les services urgents. Si un assistant met en avant trois prestataires, un appel manqué peut basculer vers le suivant.
Ici encore, prudence : ce n’est pas une loi générale du web local. C’est un retour d’expérience fournisseur rapporté par un média. Mais pour un lecteur qui gère un standard, des prises de rendez-vous ou un support hors horaires, c’est un signal très concret à surveiller. 🔎
Là où le call tracking se complique vraiment
L’une des parties les plus utiles du corpus concerne le téléphone. Beaucoup d’entreprises locales vivent d’appels, pas seulement de formulaires. Or c’est précisément là que l’attribution devient fragile.
Le problème des scripts côté navigateur
Search Engine Journal rapporte un point technique avancé par Sean McCrohan : les crawlers utilisés par des agents IA n’exécuteraient pas les scripts de page comme un navigateur classique. Si votre système de suivi repose sur un remplacement de numéro en JavaScript côté client, l’agent peut ne jamais voir ce numéro dynamique.
En clair, l’assistant peut lire le numéro par défaut dans le HTML statique, pas celui injecté plus tard dans la page.
C’est une nuance importante parce qu’elle évite un faux raccourci fréquent : “mon tracking est en place, donc mon attribution IA l’est aussi”. Pas forcément.
Le recours au server-side ne vaut pas feu vert sans test
Le même article rapporte que des remplacements côté serveur peuvent fonctionner, tout en mentionnant une mise en garde sur les risques liés au cloaking et à la cohérence des données locales.
C’est un bon exemple de contradiction utile à conserver telle quelle :
- d’un côté, un traitement côté serveur peut mieux exposer certaines informations aux crawlers ;
- de l’autre, toute variation selon l’user-agent demande une prudence extrême.
La documentation officielle de Google sur les politiques anti-spam et notamment le cloaking rappelle pourquoi ce sujet ne doit pas être bricolé à la légère.
La bonne lecture n’est donc pas “il faut faire du server-side”. La bonne lecture est : si votre attribution téléphonique dépend du navigateur, vérifiez d’abord ce que voit réellement le robot, et ce que voit l’utilisateur.
La cohérence des données locales reste un socle plus crédible qu’une astuce
Sur ce terrain, la majorité des feedbacks est assez cohérente malgré ses différences de qualité. Les articles de Search Engine Journal et de Digital360 insistent sur la nécessité de garder des informations locales stables et concordantes :
- nom d’entreprise ;
- adresse ;
- téléphone ;
- horaires ;
- zones desservies ;
- pages locales utiles par établissement.
Ce n’est pas nouveau, et c’est justement ce qui rend le signal intéressant : l’IA ne remplace pas brutalement le SEO local, elle en réutilise une partie des fondations.
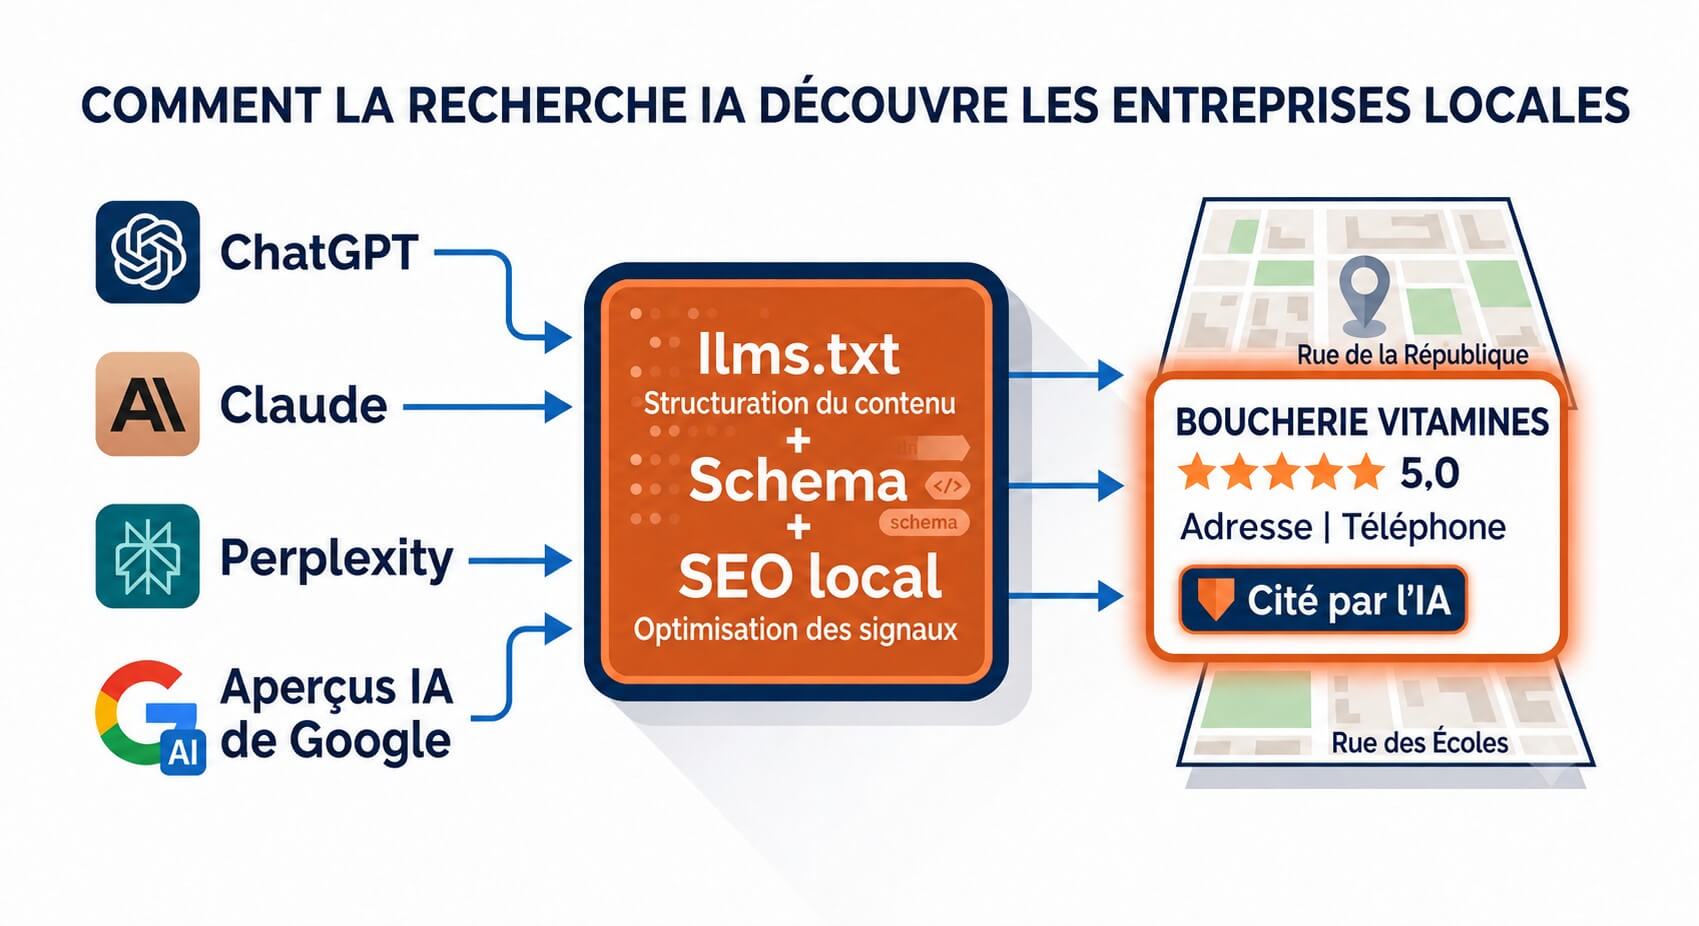
Le texte promotionnel de Chaz Edward ajoute des couches comme llms.txt, schema et “AI readiness”, mais cela ne fournit pas de preuve solide que ces éléments seraient, à eux seuls, déterminants pour la recommandation locale par les assistants. La prudence s’impose donc.
En revanche, sur un point plus classique, la documentation Google sur les bonnes pratiques de contenu pour les fonctionnalités IA de la recherche et sur les fonctionnalités IA dans la recherche Google va dans le sens d’un travail de fond : contenu utile, informations compréhensibles, structure exploitable, signaux cohérents.
Pourquoi la “position” dans un assistant n’est pas une métrique stable
L’autre idée forte concerne ce que Steve Wiideman appelle le prompt drift. Search Engine Journal cite une analyse de Steady Demand selon laquelle, pour des recherches locales répétées dans Gemini, les sources citées se recouvriraient environ 40 % du temps, et la marque recommandée en tête ne reviendrait qu’environ 7 % du temps, contre une stabilité d’environ 90 % pour le local pack de Google.
Ces chiffres sont intéressants, mais ils reposent sur une source secondaire relayée par un média, pas sur une étude méthodologique détaillée. Il faut donc retenir surtout l’idée générale : les réponses d’assistants peuvent varier fortement selon la formulation, le contexte ou la session.
Conséquence pratique : suivre “la position #1 dans ChatGPT” comme on suivait un classement classique a peu de sens. Mieux vaut observer des tendances :
- votre marque est-elle citée plus souvent ?
- les informations sont-elles exactes ?
- quelles pages ou quelles sources appuient ces réponses ?
- les mêmes faits réapparaissent-ils dans le temps ?
C’est pour cette raison que plusieurs sources évoquent des bibliothèques de prompts ou de formulations à contrôler, plutôt qu’un ranking unique.
Les mots de vos clients valent souvent plus qu’un brainstorming SEO
Sur ce point, le corpus est particulièrement utile parce qu’il recolle à une pratique simple. Search Engine Journal insiste sur la valeur des transcriptions d’appels et des logs de chat pour comprendre comment les clients formulent réellement leurs besoins.
L’idée n’a rien de spectaculaire, mais elle est solide : les assistants répondent à des formulations conversationnelles, pas seulement à des mots-clés courts et rigides. Si votre site parle un langage marketing très propre, mais éloigné des questions que vos prospects posent au téléphone, il peut y avoir un décalage.
Vous pouvez donc auditer :
1. les mots employés pour décrire un problème ;
2. les questions posées avant achat ;
3. les inquiétudes récurrentes sur le prix, les délais, la zone couverte ;
4. les expressions utilisées par vos clients que votre site n’emploie jamais.
C’est une piste utile, à condition de respecter la confidentialité, l’accès aux données et les règles applicables à l’enregistrement ou à l’analyse de conversations.
Les avis ne disparaissent pas du paysage, ils changent de portée
Tout le monde s’accorde sur l’importance des avis multi-plateformes, pas seulement ceux de Google Business Profile. Search Engine Journal rapporte que Steve Wiideman cite notamment Yelp, en rappelant ses connexions avec Bing, Apple Maps et son partenariat avec ChatGPT.
Il évoque aussi une zone cible d’environ 4,5 à 4,7 d’évaluation moyenne. Là encore, il faut éviter le piège du chiffre magique. Ce n’est pas un seuil officiel universel, c’est un repère cité dans un échange professionnel.
Ce que l’on peut retenir plus sûrement :
- des avis récents et crédibles restent des signaux de réassurance ;
- la présence sur plusieurs plateformes peut compter si les assistants agrègent des sources diverses ;
- une réputation locale absente ou incohérente peut affaiblir la confiance.
Autrement dit, si votre stratégie d’avis se limite à une seule plateforme, ce n’est pas forcément faux, mais c’est peut-être trop court pour un environnement où plusieurs jeux de données se croisent.
Une méthode raisonnable pour commencer, sans transformer un signal faible en certitude
Si vous gérez une entreprise locale ou un réseau d’établissements, voici une méthode plus prudente que la chasse au “hack IA” :
1. Identifiez le niveau exact du symptôme
Demandez-vous d’abord :
- manque-t-on de citations visibles dans les assistants ?
- reçoit-on des recherches de marque sans comprendre leur origine ?
- observe-t-on des appels manqués hors horaires ?
- le problème porte-t-il sur les données locales incohérentes ?
- ou sur la conversion après visite ?
Sans ce tri, vous risquez d’appliquer une réponse technique à un problème commercial, ou l’inverse.
2. Créez un suivi minimal, mais propre
Commencez par :
- un segment analytics pour les referrals IA identifiables ;
- une question “Comment nous avez-vous connus ?” dans les formulaires ou scripts d’appel ;
- une qualification simple des appels : nouveau lead, client existant, hors cible, appel manqué ;
- un relevé des recherches de marque et actions sur fiches locales.
Ce n’est pas parfait, mais c’est déjà plus utile qu’un verdict binaire du type “l’IA ne sert à rien” ou “tout vient de l’IA”.
3. Vérifiez ce que vos pages disent réellement à une machine
Contrôlez au minimum :
- le numéro principal affiché dans le HTML ;
- la cohérence NAP entre site, profils et annuaires ;
- les horaires, zones desservies et services par lieu ;
- l’existence de pages locales vraiment utiles, pas de doublons minces ;
- la présence de réponses claires à de vraies questions client.
4. Testez des actions réversibles d’abord
Quelques exemples d’actions réversibles :
- améliorer une page locale prioritaire ;
- clarifier un numéro d’appel et les horaires ;
- mieux capter les demandes hors horaires ;
- enrichir les réponses à des questions récurrentes ;
- lancer un audit des avis sur plusieurs plateformes.
En revanche, tout ce qui touche à des variations de contenu selon l’agent, à l’attribution téléphonique complexe ou à des fichiers et signaux présentés comme miracles mérite un test limité, documenté et relu.
Ce que les réseaux multi-sites doivent surveiller encore plus attentivement
Le corpus insiste à juste titre sur la gouvernance pour les marques multi-sites. Plus vous avez de lieux, plus vous exposez :
- des numéros non autorisés ;
- des horaires divergents ;
- des descriptions locales contradictoires ;
- des fiches en doublon ;
- des réponses aux avis très inégaux.
Search Engine Journal rapporte que Steve Wiideman place même cette gouvernance au-dessus de certains signaux de ranking classiques à grande échelle. La formule est forte, mais l’idée est crédible : quand des assistants agrègent des sources multiples, le désordre local devient plus coûteux.
Pour un réseau, la priorité n’est donc pas seulement “apparaître dans l’IA”. C’est d’éviter que l’IA recompose une image incohérente de la marque à partir de données éparpillées.
La bonne décision de départ dépend du vrai symptôme, pas du mot à la mode
Si vous ne devez retenir qu’une chose, c’est celle-ci : la visibilité dans les assistants IA peut déjà contribuer à des leads locaux, mais les preuves directes restent partielles, faibles en volume et très dépendantes du contexte.
La bonne question n’est pas “comment optimiser pour l’IA ?”. La bonne question est plutôt :
- quel niveau de cache est concerné ? Ici, par analogie opérationnelle, quel niveau du parcours garde la trace : referral visible, recherche de marque, appel, fiche locale, ou rien du tout ?
- quel symptôme est observé ? Faible trafic référent, appels hors horaires, incohérences de données, manque de citations, mauvaise conversion ?
- quels faits sont vérifiés ? Chiffres internes, logs, appels qualifiés, sources citées, tests techniques ?
- quelle action est réversible ? Ajuster une page, améliorer la collecte d’attribution, corriger les données locales, tester un dispositif hors horaires.
C’est moins spectaculaire qu’une promesse d’“AI visibility”. Mais c’est beaucoup plus solide pour prendre une décision utile.
Pour certaines entreprises, c’est peut-être déjà perdu d’avance si elles laissent l’IA influencer la décision sans même mesurer son impact réel dans le temps. Et comme tout va très vite, le plus rentable reste souvent de limiter les occasions manquées : données locales incohérentes, appels manqués, pages locales faibles et absence de question d’attribution côté équipe.
Dans la même rubrique
- JetGEO, la nouveauté Crocoblock pour WordPress : contrôle des crawlers IA ou simple couche marketing ?
Thèmes communs : Numérique · SEO · IA
- Gemini 2.0: Google redéfinit l’IA avec son modèle agent révolutionnaire
Thèmes communs : Numérique · IA
- Nov 2021 Spam Update: Google Publie une Mise à Jour Anti-Spam
Thèmes communs : Analytics · Numérique · SEO
- Search Profiles Google : ce qui change pour les médias et créateurs américains en septembre 2026
Thèmes communs : Numérique · SEO
Affaire Revolut: Comment une Adresse Institutionnelle a pu servir à une Fuite de données
Une PEC italienne aurait servi à obtenir les données de centaines de clients Revolut. Les faits connus, l’enjeu KYC et les questions de confidentialité.
Lire l’article
Vider le cache DNS ne règle pas tout : Cloudflare montre pourquoi
Un site ne répond plus, mais seulement chez un utilisateur ? Le réflexe “flush DNS” peut aider. Mais si vous confondez cache local, cache…
Lire l’article
TikTok fait Tomber le Masque du Luxe : les Usines Chinoises Balancent Tout
📢"Chinese manufacturers" : La guerre commerciale entre la Chine et les États-Unis expose les coulisses du luxe : les fabricants chinois passent à l’attaque
Lire l’article